Le cycle d'une requête API
Mis à jour le 30 juillet 2026
Comprendre le trajet d’une requête n’est pas un détour théorique : c’est ce qui vous permettra de savoir, quand quelque chose ne va pas, où chercher. Une réponse tronquée, une latence anormale et une facture inattendue ont chacune leur origine à une étape précise de ce parcours, et les confondre fait perdre des heures.
Les 5 étapes d’une requête
Client (navigateur/app)
        ↓
Votre serveur backend
        ↓
API Anthropic
        ↓
Traitement par le modele
        ↓
Reponse renvoyee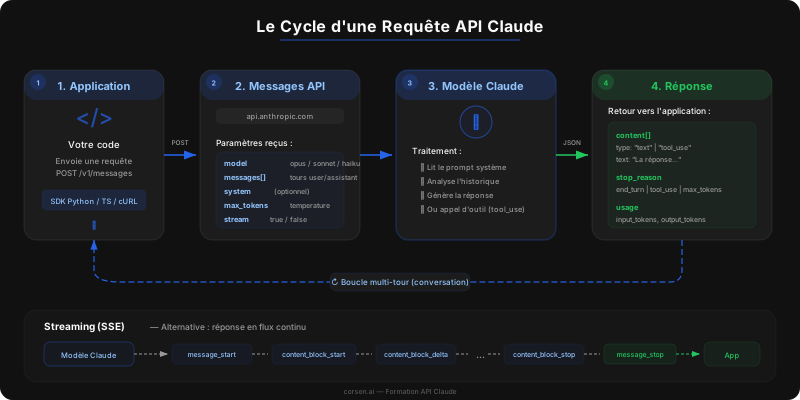
- Le client (navigateur, application mobile, script) envoie une demande à votre serveur
- Votre serveur reçoit la demande et construit la requête API avec votre clé
- L’API Anthropic valide la requête et la transmet au modèle
- Le modèle traite le prompt et génère une réponse
- La réponse remonte : modèle → API → votre serveur → client
Pourquoi un serveur intermédiaire ?
C’est la règle la plus importante de cette leçon, et elle n’a pas d’exception. Si votre clé se retrouve dans le code JavaScript d’une page web, n’importe qui peut l’ouvrir dans les outils de développement et l’utiliser à vos frais — le code envoyé au navigateur est, par construction, lisible par tout le monde. Aucune obfuscation ni variable d’environnement côté front n’y change quoi que ce soit. Votre serveur backend sert de rempart : c’est lui qui detient la clé et communique avec l’API.
Les champs essentiels d’une requête
Chaque requête à l’API nécessite au minimum :
import anthropic

client = anthropic.Anthropic()  # Utilise ANTHROPIC_API_KEY depuis l'environnement

message = client.messages.create(
    model="claude-sonnet-5",   # Le modèle a utiliser
    max_tokens=1024,                     # Nombre max de tokens en sortie
    messages=[                           # La conversation
        {"role": "user", "content": "Bonjour Claude !"}
    ]
)
Les trois paramètres obligatoires :
model: quel modèle utilisermax_tokens: limite de tokens pour la réponse (sécurité anti-explosion de coûts)messages: la liste des messages de la conversation
Ce que fait Claude en interne
Ces quatre étapes internes expliquent deux comportements que l’on constate sans toujours les relier. D’abord, la facturation se fait en tokens et non en mots ou en caractères — c’est la tokenisation qui décide, et un texte français coûte généralement plus de tokens qu’un texte anglais de même longueur. Ensuite, la réponse arrive progressivement parce qu’elle est produite progressivement, un token après l’autre : c’est ce qui rend le streaming possible, et ce qui explique qu’une réponse longue prenne plus de temps qu’une réponse courte.
- Tokenisation : le texte est découpé en tokens (morceaux de mots). “Bonjour” peut devenir un ou plusieurs tokens
- Embedding : chaque token est converti en un vecteur numérique
- Contextualisation : le modèle analyse les relations entre tous les tokens via le mécanisme d’attention
- Génération : le modèle prédit le prochain token, puis le suivant, et ainsi de suite jusqu’à avoir terminé
Quand Claude arrête-t-il de générer ?
Ce champ mérite d’être lu par votre code, pas seulement consulté en débogage : c’est lui qui distingue une réponse terminée d’une réponse coupée. Une réponse tronquée à cause de max_tokens ressemble en tout point à une réponse normale — texte cohérent, aucune erreur — sauf qu’il lui manque la fin. Sans vérification de stop_reason, vous l’enregistrerez comme complète.
max_tokensatteint : la réponse est coupée à la limite que vous avez définie (stop_reason:max_tokens)- Fin naturelle : le modèle estime avoir terminé sa réponse (stop_reason:
end_turn) - Séquence d’arrêt : vous avez défini une séquence de stop personnalisée et le modèle l’a générée (stop_reason:
stop_sequence)
Structure de la réponse
Message(
    id='msg_01XFDUDYJgAACzvnptvVoYEL',
    type='message',
    role='assistant',
    content=[
        TextBlock(type='text', text='Bonjour ! Comment puis-je vous aider ?')
    ],
    model='claude-sonnet-5',
    stop_reason='end_turn',
    usage=Usage(
        input_tokens=12,
        output_tokens=15
    )
)
Les champs importants :
content: la réponse générée (liste de blocs, généralement un seul TextBlock)stop_reason: pourquoi le modèle s’est arrêtéusage: nombre de tokens consommés (entrée + sortie) — utile pour suivre vos coûts
Pour extraire le texte de la réponse :
reponse = message.content[0].textDans la prochaine leçon, nous obtiendrons une clé API pour passer à la pratique.