Introduction aux évaluations
Mis à jour le 28 juillet 2026
Pourquoi évaluer ?
Les évaluations de prompts, couramment appelées « evals », sont un élément critique du développement d’applications IA. Tant que vous n’en avez pas, vous naviguez à l’aveugle : vous modifiez une formulation, vous relisez trois réponses, vous trouvez que « c’est mieux », et vous déployez. Trois semaines plus tard, un utilisateur signale un comportement que vous aviez pourtant corrigé — et vous n’avez aucun moyen de savoir quel changement l’a réintroduit. Une évaluation transforme cette impression en mesure : le même jeu d’entrées passe dans l’ancien et le nouveau prompt, et un chiffre vous dit lequel gagne.
« L’incapacité des équipes à mesurer la performance de leurs modèles est le principal obstacle aux cas d’usage en production pour les LLM. »
Benchmarks et évaluations personnalisées
Il faut distinguer deux familles d’outils que l’on confond souvent. Les benchmarks — ARC, MMLU, TruthfulQA et leurs équivalents — sont les tests standardisés du monde de l’IA. Ils mesurent des capacités générales : compréhension, raisonnement, connaissances encyclopédiques. Ils servent à comparer des modèles entre eux et donnent une indication utile au moment de choisir une base de départ, mais ils ne vous disent rien sur votre cas d’usage spécifique. Un modèle légèrement mieux classé sur MMLU peut se révéler moins bon que son concurrent pour trier vos tickets de support.
C’est là que les évaluations personnalisées entrent en jeu. Elles mesurent comment un couple modèle + prompt se comporte sur votre tâche précise, avec vos données et vos critères de réussite. L’image du couteau suisse est parlante : la note globale de l’outil vous intéresse moins que sa capacité à faire le geste dont vous avez besoin. Si votre application extrait des numéros de commande dans des courriels clients, votre évaluation contient des courriels clients et des numéros de commande, pas des questions de culture générale.
Le cycle d’évaluation
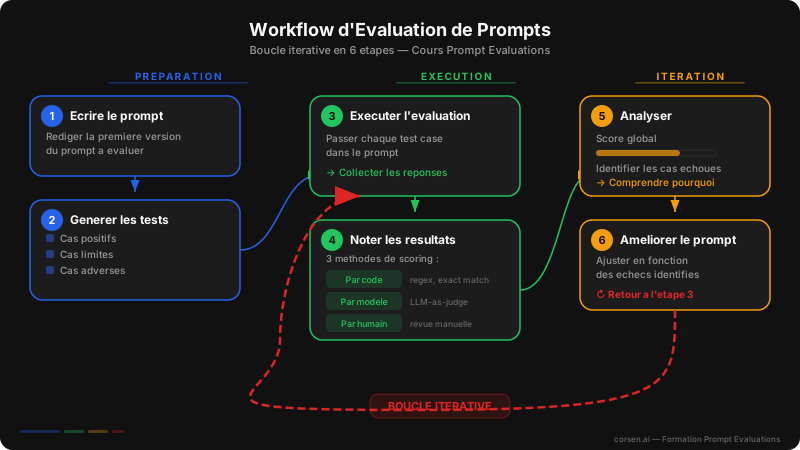
Le travail suit toujours la même boucle, que vous l’exécutiez à la main ou dans un pipeline automatisé :
- Développer les cas de test : des paires (entrée, sortie attendue)
- Écrire un brouillon de prompt
- Tester et mesurer : obtenir un score de base
- Itérer : modifier le prompt, re-tester, comparer
L’ordre compte. Beaucoup d’équipes commencent par le prompt et bricolent des tests ensuite pour justifier ce qu’elles ont écrit. En construisant les cas de test d’abord, vous êtes obligé de formuler ce qu’est une bonne réponse avant de savoir comment l’obtenir. Le score de base de l’étape 3 est tout aussi essentiel : sans lui, vous ne saurez jamais si votre troisième version de prompt fait mieux ou moins bien que la première. Les évaluations servent précisément à quantifier la qualité d’une combinaison prompt + modèle ; sans métrique, toute optimisation reste une affaire d’opinion.
Les composants d’une évaluation
Une évaluation, quelle que soit sa sophistication, repose sur quatre éléments. L’entrée d’exemple est la question ou l’instruction soumise au modèle — dans un classificateur de sentiment, ce serait un avis client réel. La réponse de référence est la sortie idéale ou correcte associée à cette entrée : ici, l’étiquette POSITIF. La logique de notation décrit comment comparer ce que produit le modèle à cette référence, du simple test d’égalité à une évaluation nuancée. La métrique est enfin le score numérique qui en résulte, celui que vous suivrez d’une version à l’autre.
Ces quatre pièces sont indissociables. Une entrée sans référence ne permet aucune comparaison, et une référence sans logique de notation vous ramène à la lecture manuelle que vous cherchiez à éviter.
Trois façons de noter
La notation par un humain reste l’étalon-or pour tout ce qui demande du jugement : le ton, la créativité, un raisonnement complexe, la factualité dans un domaine expert. Un relecteur juriste saura dire si une clause reformulée conserve son sens juridique, là où aucune règle automatique ne le peut. C’est précis et c’est coûteux, ce qui la réserve en pratique aux échantillons.
La notation par code procède à une comparaison programmatique : correspondance exacte, expression régulière, vérification de format. Elle est rapide, déterministe et parfaitement adaptée aux tâches dont les critères sont objectifs — vérifier que la sortie est un JSON valide contenant les champs attendus prend quelques millisecondes et donne toujours le même verdict.
La notation par modèle confie à un LLM le soin de juger la sortie d’un autre LLM selon des critères que vous rédigez. Elle offre un compromis intéressant : elle absorbe une partie de la souplesse du jugement humain tout en passant à l’échelle comme du code. Les leçons suivantes détaillent chacune de ces approches et la manière de les combiner. Les construire demande du travail, et c’est ce travail qui fonde une application LLM de production : le temps investi dans de bonnes évaluations se retrouve en performance et en confiance dans votre système.
Points clés à retenir
- Sans évaluation, l’amélioration d’un prompt repose sur des impressions et les régressions passent inaperçues.
- Les benchmarks comparent des modèles entre eux ; seules des évaluations personnalisées mesurent votre tâche.
- Le cycle est toujours le même : cas de test, brouillon de prompt, mesure de base, itération.
- Une évaluation combine une entrée, une réponse de référence, une logique de notation et une métrique.
- Trois modes de notation coexistent — humain, code, modèle — et se choisissent selon la nature du critère.